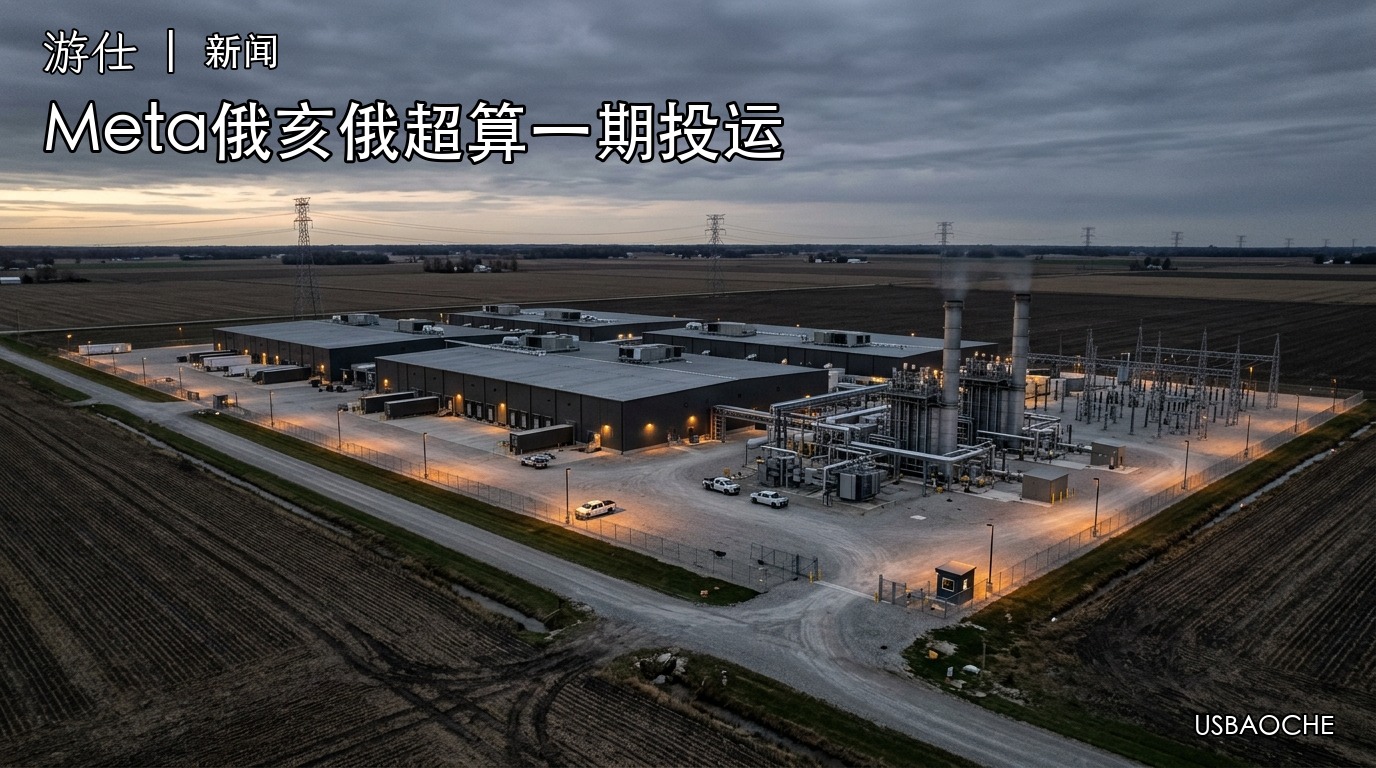
将一座原本服务于传统社交网络业务的数据中心,直接改造成容纳数十万张加速卡的人工智能超算基地,需要跨越怎样的工程与能源门槛?Meta在10月19日(美东时间)披露的工程技术博文中给出了答案:其位于美国俄亥俄州新阿尔巴尼(New Albany)的Prometheus数据中心园区一期工程已正式投入运行。这座园区由原有的传统Facebook数据中心改建而来,目前已将传统数据中心建筑、AI优化建筑以及快速部署结构全面互联,容纳了数十万张GPU,用于训练其Muse基础模型。
行业媒体Data Center Dynamics于10月23日(美东时间)报道指出,按照Meta的规划,Prometheus园区的电力规模最终将扩展至1吉瓦(1 GW),在满负荷状态下预计容纳约100万张分布式GPU。当单座园区的算力规模推升至百万卡级别、规划功耗达到吉瓦级时,传统机房的散热设计、跨建筑网络通信以及地方电力供应都面临考验。Meta在俄亥俄州的一期落地,展现了其如何通过底层硬件定制与跨建筑网络互联,推进大模型算力基础设施的扩张。
从GB200到Vera Rubin,数十万张芯片如何塞进同一座园区?
在硬件配置上,Prometheus一期目前已容纳数十万张GPU,内部部署了英伟达(Nvidia)的GB200和GB300芯片,而下一代Vera Rubin架构芯片也即将运抵。为了将这些高功耗芯片高效集成,Meta针对不同代际的硬件采用了定制化的机架与散热架构。
根据Meta工程团队公布的技术细节,针对GB200芯片,园区采用了Catalina机架架构下的Ariel变体方案。这是一种双机架配置,每个机架搭载36张GPU,通过NVLink互联形成一个包含72张GPU的统一计算域(即GB200 NVL72)。在Ariel变体中,每一张英伟达Blackwell GPU都按1:1的比例配有一颗Grace CPU以及两张ConnectX-7 400G网卡(NIC),从而为单张GPU提供高达800G的输入/输出(I/O)带宽。
而在部署更新一代的GB300芯片时,Meta切换到了Clemente平台。该平台在散热方案上具备高度灵活性,既可以使用Meta模块化的风液混合冷却系统(AALC,Air-Assisted Liquid Cooling),也可以直接接入厂房级液冷系统(FLC,Facility Liquid Cooling)。Meta方面表示,GB300将单张GPU的高带宽内存(HBM)容量提升了1.5倍,从192GB增加至288GB,密集FP4计算吞吐量也按相近幅度提升,同时将注意力机制(softmax)的加速能力大致翻倍。Meta还指出,在平台层面上,由于英伟达ConnectX-8超级网卡(SuperNIC)原生即可为单张GPU提供800G带宽,横向扩展(scale-out)已不再像在GB200 NVL72上那样构成制约,早期在Ariel架构上部署的通信能力如今已成为基础标配。
对于即将到来的下一代硬件,Meta计划通过即将推出的San Miguel平台,以NVIDIA Vera Rubin NVL72规格进一步扩充Prometheus园区的算力容量。
跨越百公里的百万卡集群,如何解决网络延迟与算力损耗?
当数十万乃至上百万张GPU无法装进同一栋建筑时,跨楼宇甚至跨区域的网络通信就成为决定集群能否像“一台计算机”那样协同工作的关键。在Prometheus园区内,Meta将原有的传统机房、新建的AI专用机房以及模块化快速部署建筑连成一体,构建了多层级的网络架构。
在单栋建筑层面,基于以太网的通信网络(Ethernet-based fabric)通过高带宽、低延迟的多层拓扑结构,最多可将20,736张GPU连接在一起。而在建筑与建筑之间,这些楼宇级网络则通过后端聚合网络(BAG,Backend Aggregation network)实现互联,其物理跨度从2公里延伸至超过100公里。
Meta披露,这套后端聚合网络采用Arista 7800系列机箱构建,内部运行具备深度缓冲能力的博通(Broadcom)Jericho3芯片,能够在每个区域对(region pair)之间提供每秒数拍比特(multiple Pbps)的传输带宽。
在模型训练的实际效率方面,根据Meta公布的数据,在使用Prometheus集群训练其Muse系列模型时,Muse Wonder的预训练运行实现了超过85%的有效算力利用率(goodput),而在强化学习运行中的有效算力利用率则超过了90%。
吉瓦级超算园区落地,地方电力供应与周边社区面临什么?
支撑数十万张乃至上百万张GPU全天候运转,底层离不开大规模的电力供应。Prometheus园区规划的远期规模达到1吉瓦。而在园区邻近地区,另有一座面向相邻数据中心、由Meta关联公司使用的表后电站早在2025年即已获批作为能源配套。
根据俄亥俄州电力选址委员会(Ohio Power Siting Board)于2025年9月18日发布的官方公告(案号 25-188-EL-BGN),该机构已于2025年9月正式批准Will-Power OH, LLC建设一座装机容量为200兆瓦(200 MW)的Socrates North天然气发电设施。监管文件明确指出,该发电厂将在电表后端直接为相邻的数据中心供电,不与公共电网发生物理连接,所生产的电力由Meta的关联公司Sidecat使用。
除了俄亥俄州的1吉瓦Prometheus集群外,Meta还在推进更大规模的算力基建项目。Data Center Dynamics报道指出,Meta计划将其位于路易斯安那州里奇兰教区(Richland Parish)、名为Hyperion的数据中心园区扩建至5吉瓦(5 GW)容量,并在当地投资最高500亿美元。
对北美科技从业者、能源行业以及算力中心周边的居民而言,这类超大规模项目的推进有着多方面的现实影响:一方面,吉瓦级数据中心及配套设施的建设,为当地带来了大规模的工程建设需求——仅路易斯安那州Hyperion一处园区的计划投资额最高就达500亿美元;另一方面,从一般性行业观察来看,通过表后专设天然气电厂直接向相邻数据中心供电、不与公共电网物理连接,虽然在物理结构上将由该电站直接承接的负荷与地方公共电网隔离开来,但也可能让外界关注区域天然气供应调配、本地化石能源排放以及土地与水资源消耗等后续问题。
游仕觀察
Meta在俄亥俄州Prometheus园区的投运与扩建,折射出其在人工智能基础设施布局上的两个实质性动向。
其一,算力扩张已从单纯的“采购芯片”演变为考验工程整合能力的“系统战”。如何把传统机房、AI优化建筑与快速部署结构整合进跨度从2公里到超过100公里的后端聚合网络中,以及如何在Muse Wonder的预训练和强化学习运行中分别实现超过85%和90%的有效算力利用率,体现了巨额硬件投入向实际训练效率转化的工程要求。
其二,电表背后的电源配置正在成为数据中心用电的现实选择之一。当Meta将单个数据中心园区的规划容量推向1吉瓦乃至5吉瓦规模时,电力基础设施的供能方式也在发生变化。像Socrates North这样早在2025年9月即获批(案号 25-188-EL-BGN)、不接入公共电网且为相邻数据中心供电的200兆瓦级表后天然气电站,意味着超大规模算力相关方正在通过引入表后发电设施来保障能源供给。未来围绕AI算力扩张的监管看点,或将越来越多地延伸到州一级的电力选址委员会与能源基础设施审批桌上。
来源
- Meta:Meta在Muse Wonder的预训练运行中实现了超过85%的goodput,在强化学习运行中实现了超过90%的goodput。
- 行业媒体Data Center Dynamics:Meta披露俄亥俄州Prometheus数据中心园区,一期已正式投运。
- 俄亥俄州电力选址委员会(Ohio Power Siting Board):该机构于2025年9月18日批准(案号 25-188-EL-BGN)Will-Power OH, LLC建设一座200兆瓦的Socrates North天然气发电设施,该设施在表后为相邻数据中心供电且不与电网物理连接,电力由Meta关联公司Sidecat使用。
- Data Center Dynamics:Meta计划将位于路易斯安那州Richland Parish、名为Hyperion的数据中心园区扩建至5 GW容量,并在当地投资最高500亿美元。
https://content.govdelivery.com/accounts/OHPUC/bulletins/3f348f9